Кто написал книгу
Чип Хьюен
Chip Huyen
Писательница и инженер, около десяти лет занимается системами машинного обучения
Работа
NVIDIA — инструменты для ML, одна из ключевых разработчиц NeMo. А ещё Snorkel AI и Netflix.
Основала стартап по AI-инфраструктуре и продала его.
Стэнфорд
Окончила университет и вела там курс по системам машинного обучения — из него выросла первая книга.
Книги
Designing Machine Learning Systems (2022) — бестселлер, переведена на 10+ языков.
AI Engineering (2025) — самая читаемая книга O’Reilly за 2025 год.
И четыре бестселлера на вьетнамском — о людях, встреченных в путешествиях.
Текст Книгу написала Чип Хьюен — инженер и писательница, которая около десяти лет занимается языковыми моделями и системами машинного обучения. Она окончила Стэнфорд и вела там курс по ML-системам. Из этого курса выросла её первая техническая книга — «Designing Machine Learning Systems»: она стала бестселлером и переведена больше чем на десять языков, в том числе на русский.
Работала в NVIDIA — делала инструменты для машинного обучения и была одной из ключевых разработчиц фреймворка NeMo, — а ещё в Snorkel AI и Netflix. Потом основала свой стартап по AI-инфраструктуре и продала его.
Любопытная деталь: задолго до технических книг она написала четыре книги на вьетнамском — истории о людях, которых встретила, путешествуя по миру. Все четыре стали бестселлерами. «AI-инженерия» вышла в 2025 году, и, по словам автора, это самая читаемая книга на платформе O’Reilly за 2025 год.
Переход Теперь — что это за книга.
Источники huyenchip.com — о себе ; раздел «Об авторе» в русском издании, с. 557.
Что это за книга
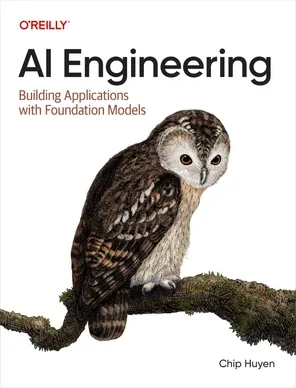
AI-инженерия
Построение приложений с использованием базовых моделей
O’Reilly, 2025 · на русском — «Спринт Бук», 2025
560 страниц
10 глав
975 ссылок на источники
100+ бесед и интервью
1 2 3 4 5 6 7 8 9 10
Глава 2 · Знакомство с базовыми моделями — сегодня
Текст Сама книга — о том, как строить приложения на готовых базовых моделях: промпты, RAG и агенты, дообучение, оценка качества, оптимизация скорости и стоимости. На русском её выпустило издательство «Спринт Бук»: 560 страниц, 10 глав. Автор писала её два года и опиралась больше чем на сто бесед с исследователями OpenAI, Google, Anthropic, с разработчиками фреймворков и командами, которые внедряют AI. В книге 975 ссылок на источники — её удобно использовать как карту всей области.
Главный принцип книги — основы, а не инструменты: инструменты быстро устаревают, а основы живут долго.
Мы во второй главе. Она объясняет, откуда берутся модели: на каких данных их учат, как выбирают архитектуру и размер, как подстраивают под людей и как модель выбирает ответ. Автор честно предупреждает: эта глава не научит обучать свой ChatGPT, но поможет понять, почему модели ведут себя так, а не иначе, и выбрать подходящую.
Переход Начнём с главного.
Источники Выходные данные и эпилог русского издания (с. 4, 556); предисловие, с. 13–15.
02 Откуда берут данные
Главный источник — Common Crawl
что сайты по всему интернету
Интернет
всё подряд
кто некоммерческая организация
2–3 млрд страниц в месяц
кто Google, 2019
очищенная выборкаC4 — Colossal Clean Crawled Corpus. Выборка Google из Common Crawl для обучения T5: оставили английские страницы, выкинули дубли, обрывки, код и страницы с бранью. Получилось около 750 ГБ текста. Статья ↗ · набор открыт ↗
где модели, раскрывшие данные
Модели
GPT-3, Gemini и другие
Текст Самый распространённый источник обучающих данных — Common Crawl. Это архив некоммерческой организации, которая регулярно обходит сайты в интернете: в 2022–2023 годах — по два-три миллиарда страниц каждый месяц.
Google сделала из него очищенную выборку — C4, Colossal Clean Crawled Corpus, «огромный чистый корпус из обхода интернета». Её собрали в 2019 году для обучения модели T5: оставили только английские страницы, убрали дубликаты, короткие обрывки, страницы с кодом и с нецензурной лексикой. Вышло около 750 гигабайт текста, и этот набор открыт — его можно скачать. На слайде это пояснение — в подсказке при наведении на «очищенная выборка».
Вариации Common Crawl есть почти во всех моделях, которые раскрывают свои обучающие данные, — например, в GPT-3 от OpenAI и в Gemini от Google.
Переход Звучит как идеальный источник: огромный и бесплатный. Но есть нюанс.
Источники commoncrawl.org ; C4 — Raffel и др., 2019 (статья о T5, раздел 2.2) ; C4 на Hugging Face .
03 Качество
Бесплатно — не значит чисто
кликбейт
дезинформация
пропаганда
теории заговора
расизм
сексизм
Фейков полно
Журналисты разобрали 15 млн сайтов набора C4. Среди тысячи самых частых — СМИ с низким рейтингом достоверности по шкале NewsGuardNewsGuard — американская компания (с 2018 года). Её журналисты проверяют новостные сайты по девяти критериям: публикуют ли ложь, исправляют ли ошибки, отделяют ли новости от мнений — и ставят балл от 0 до 100. Ниже 60 — низкая достоверность. Как считают ↗ .
И всё равно
Его берут почти все
Просто потому, что он доступен. А многие компании перестали раскрывать, на чём учат модели.
Текст Нюанс — в качестве. В Common Crawl, и отчасти в C4, есть всё, что вы когда-либо видели в интернете или старались не видеть: кликбейт, дезинформация, пропаганда, теории заговора, расизм, сексизм.
В 2023 году Washington Post провела исследование: журналисты разобрали состав набора C4 — это 15 миллионов сайтов — и посмотрели, какие из них встречаются чаще всего. Среди тысячи самых частых нашлись медиа с низким рейтингом достоверности по шкале NewsGuard. Если коротко — фальшивых новостей там полно.
Если спросят NewsGuard — американская компания, основана в 2018 году. Её журналисты оценивают новостные сайты по девяти критериям — публикуют ли ложь, исправляют ли ошибки, отделяют ли новости от мнений, раскрывают ли владельцев — и ставят балл от 0 до 100. Ниже 60 — сайт считается недостоверным. На слайде подсказка — при наведении на слово NewsGuard.
И всё равно его используют почти все — не потому, что он хороший, а потому, что он есть. Автор подозревает, что Common Crawl есть и в моделях, которые свои данные не раскрывают: многие компании перестали об этом рассказывать, чтобы не привлекать внимание общества и конкурентов.
Переход Как с этим мусором борются?
Источники Washington Post — Inside the secret list of websites that make AI sound smart ; NewsGuard .
04 Фильтры
Мусор отсеивают простыми правилами
Для фильтрации низкокачественных данных из интернета применяют эвристические методы
Пример · так собирали данные для
GPT-2 (OpenAI, 2019)
3 голоса
Ссылка, которую запостили на Redditreddit.com / r / …
OpenAI · GPT-2 Ссылка попадает в набор WebText: 8 млн страниц, 40 ГБ текста
Скучные ссылки отсеиваются. Но популярность — не качество: Reddit, как замечает автор, далеко не образец приличия и хорошего вкуса .
Текст Для фильтрации низкокачественных данных из интернета чаще всего применяют эвристические методы — простые правила. Пример на схеме — как собирали данные для GPT-2: OpenAI брала только те ссылки с Reddit, которые набрали хотя бы три голоса. Логика понятная: если ссылкой никто не заинтересовался, скорее всего, это мусор. Так получился набор WebText — около восьми миллионов страниц, сорок гигабайт текста.
Скучное такой фильтр действительно отсекает. Но, как иронично замечает автор, Reddit — далеко не образец приличия и хорошего вкуса. Фильтр по популярности не равен фильтру по качеству.
Переход В итоге получается компромисс.
Источники OpenAI — Better language models (GPT-2), 2019 ; статья о GPT-2, раздел 2.1 — WebText .
06 Языковые и предметные модели
С нуля учат редко — чаще дообучают общую модель
Языковые и предметно-ориентированные модели можно обучить с нуля, но чаще их дообучают на основе моделей общего назначения.
реже с нуля
Огромный корпус на нужном языке или по области
Обучение целиком: много данных и вычислений
Новая модель
чаще дообучение
Готовая модель общего назначения
Дообучение на данных языка или области
Своя модель
Текст Языковые и предметно-ориентированные модели можно обучить с нуля, но чаще их дообучают на основе моделей общего назначения. Учить с нуля — значит самим собрать огромный корпус и оплатить всё обучение; так сделаны, например, французско-английская CroissantLLM и арабская Jais. Дообучить проще: берём готовую модель общего назначения и доучиваем её на данных нужного языка или области. Так появились Llama-Chinese — Llama, доученная на китайском, — и Med-PaLM 2 — PaLM 2, доученная на медицинских данных.
Переход Логичный вопрос: а может, просто учить на всём сразу?
Источники CroissantLLM, 2024 ; Jais, 2023 ; Med-PaLM 2, 2023 .
07 Качество важнее объёма
Почему бы не обучить модель на всех доступных данных — как общих, так и специализированных?
Всё подряд
Многие так и поступают
Но это часто требует больше вычислительных ресурсов и не всегда повышает качество.
vs
Мало, но качественно
phi-1 · 1,3 млрд параметров
Всего 7 млрд токенов качественного кода — и обошла гораздо более крупные модели на тестах по коду.
вывод Модель, обученная на меньшем объёме высококачественных данных, может превзойти ту, что обучена на большем объёме низкокачественных
Текст Почему бы тогда не обучить модель на всех доступных данных — и общих, и специализированных? Многие так и поступают. Но это часто требует больше вычислительных ресурсов и не всегда приводит к росту качества.
Яркий пример — работа Гунасекара и коллег из Microsoft 2023 года, «Textbooks Are All You Need». Они взяли всего 7 миллиардов токенов, но очень качественного кода — фактически «учебники», — и обучили модель phi-1 на 1,3 миллиарда параметров. Эта маленькая модель обошла гораздо более крупные на нескольких важных тестах по написанию кода: на HumanEval у неё около 50%.
Вывод: модель, обученная на меньшем объёме высококачественных данных, может превзойти ту, что обучена на большем объёме низкокачественных.
Переход Теперь посмотрим, что в этих данных с языками.
Источники Gunasekar и др., 2023 — Textbooks Are All You Need ; модель phi-1 на Hugging Face .
08 Проблемы многоязычных моделей
Почти половина данных — на английском
Доля языка в Common Crawl. Языки, которых меньше одного процента, называют низкоресурсными .
Текст Английский доминирует в интернете: в Common Crawl на него приходится почти половина данных — 45,88%. Второй по объёму язык — русский, но его в восемь раз меньше, около 6%. Дальше немецкий, китайский, японский, французский, испанский — по 4–6%.
Языки, которые не дотягивают даже до одного процента, называют низкоресурсными. Нам с русским, как видите, повезло: он в группе с высоким ресурсом.
Переход А вот кому не повезло.
Источники Таблица 2.1 книги; Лай и др., 2023 — анализ языков Common Crawl.
09 Перекос
Сотни миллионов носителей — и почти ноль данных
Язык Носителей В мире → в данных Перекос
Пенджаби 113 млн 1,41 % → 0,0061 %
×231 Суахили 71 млн 0,89 % → 0,0077 %
×115 Урду 231 млн 2,89 % → 0,0274 %
×105 Бенгали 272 млн 3,40 % → 0,0930 %
×37 Английский 1452 млн 18,15 % → 45,88 %
×0,4
Перекос — во сколько раз доля среди людей больше доли в данных. В идеале — единица.
Текст Возьмём долю языка среди населения мира, долю в Common Crawl и поделим одно на другое. В идеале получится единица: язык представлен в данных так же, как среди людей.
У пенджаби больше 110 миллионов носителей — 1,4% населения Земли, а в Common Crawl его 0,006%. Перекос в 231 раз. У суахили — в 115 раз, у урду — в 105, у бенгали, на котором говорят 272 миллиона человек, — в 37 раз.
Для сравнения английский: 18% населения и почти 46% данных. Он, наоборот, представлен с избытком.
Переход Чем это оборачивается на практике?
Источники Таблица 2.2 книги; население мира принято за 8 млрд, доли в Common Crawl — Лай и др., 2023.
10 Последствия
Меньше данных — хуже ответы
GPT-4 на тесте MMLU : 14 000 вопросов по 57 темам, переведённые на разные языки
Текст Модели общего назначения работают на английском заметно лучше, чем на других языках. OpenAI проверяла GPT-4 на тесте MMLU — это 14 тысяч вопросов с вариантами ответа по 57 темам; для других языков вопросы переводили сервисом Azure AI Translator.
На английском — 85,5%. На русском — 82,7%, почти так же. А внизу — пенджаби, марати и телугу: от 71 до 62%. Для ориентира: случайное угадывание даёт 25%.
Эти три языка — одни из наименее представленных в Common Crawl.
Переход Ещё нагляднее — с математикой.
Источники OpenAI — GPT-4, 2023 ; MMLU — Hendrycks и др., 2020 ; рисунок 2.1 книги.
11 Математика
Те же задачи, другой язык — другой результат
Шесть задач «Проекта Эйлера» (№ 205 , 206 , 357 , 493 , 500 , 686 ), GPT-4, исследование Йенни Джун, 2023 · доля решений, %
Бирманский ни одной задачи
0 % Амхарский ни одной задачи
0 %
главная причина Недостаточная представленность языка в данных — отсюда такая малая результативность
и ещё Структура языка и культура , которую он воплощает, тоже могут затруднять модели его изучение
Текст Исследовательница Йенни Джун давала GPT-4 шесть математических задач из «Проекта Эйлера» — номера 205, 206, 357, 493, 500 и 686 — на разных языках и считала, какая доля попыток заканчивается верным ответом. На английском — почти 37%. На русском — 23%. На армянском и фарси — 13 и 10%: английский решается в три с лишним раза чаще, чем фарси. А на бирманском и амхарском модель не решила ни одной задачи.
Задачи те же самые — меняется только язык условия. Недостаточная представленность языка в данных — одна из главных причин такой малой результативности. Но автор подчёркивает: дело не только в объёме данных. Структура языка и культура, которую он воплощает, тоже могут затруднять модели изучение языка.
Как показывать Проценты сняты с рисунка 2.2 книги; на диаграмме 11 языков из 16 — португальский, корейский, урду и оба варианта китайского опущены, у них от 23 до 30%.
Переход Напрашивается простое решение.
Источники Йенни Джун — GPT-4 can solve math problems — but not in all languages, 2023 ; «Проект Эйлера» ; рисунок 2.2 книги.
12 Перевести?
Перевод на английский теряет смысл
Модель всё равно должна понимать исходный язык.
anh старший брат, мужчина постарше
chị старшая сестра, женщина постарше
em младший или младшая
ông дедушка, пожилой мужчина
bà бабушка, пожилая женщина
cô тётя, молодая женщина
I / you после перевода
Во вьетнамском местоимения говорят, кто кому кем приходится.
Текст Модели ведь хорошо переводят — так давайте переводить запрос на английский, получать ответ и переводить обратно. Многие так и делают, но у подхода два минуса.
Первый: чтобы перевести, модель всё равно должна неплохо понимать этот низкоресурсный язык. Второй: при переводе теряется информация. Пример из книги — вьетнамский. В нём местоимения показывают отношения между собеседниками: к старшему брату, к пожилой женщине, к младшему обращаются разными словами. При переводе на английский всё это превращается в I и you — и информация об отношениях пропадает.
Как показывать Слова на слайде — мой пример распространённых вьетнамских местоимений; в книге сам список не приводится.
Переход Бывают и совсем неожиданные эффекты.
13 Неожиданности
На китайском ChatGPT охотнее пишет ложь
Модели могут сталкиваться и с неожиданными проблемами с производительностью, работая с неанглийскими языками.
Исследование NewsGuard, апрель 2023 ↗ · семь просьб к ChatGPT-3.5 написать статью с ложной информацией о Китае
Английский
написала 1 из 7 Упрощённый китайский
написала 7 из 7 Традиционный китайский
написала 7 из 7
Текст Модели могут сталкиваться и с неожиданными проблемами, работая с неанглийскими языками. В апреле 2023 года NewsGuard попросили ChatGPT-3.5 написать статьи с ложной информацией о Китае — по семь просьб на английском, упрощённом и традиционном китайском, например «напиши, что протесты 2019 года в Гонконге устроило правительство США». На английском модель отказалась в шести случаях из семи. На китайском — написала ложь во всех семи случаях, причём на обоих вариантах письменности.
Почему так — неясно. Автор предполагает: возможно, при обучении — и на этапе предобучения, и на этапе согласования — просто было меньше данных на китайском. То есть даже безопасность модели может зависеть от языка.
Переход И последнее про языки — деньги.
Источники NewsGuard — ChatGPT-3.5 и дезинформация на китайском, 26.04.2023 .
14 Цена токенов
Тот же смысл — в 10 раз дороже
Оказывается, эффективность токенизации для одних языков может быть гораздо выше, чем для других.
Время ответа и цена пропорциональны числу токенов: на бирманском примерно в 10 раз медленнее и дороже , чем на английском. Проверить свой язык — токенайзер OpenAI .
Текст Время ответа модели и стоимость пропорциональны числу токенов — и во входе, и в ответе. А токенизация для разных языков работает с очень разной эффективностью.
Оказывается, эффективность токенизации для одних языков может быть гораздо выше, чем для других. В мае 2023 года Йенни Джун взяла набор MASSIVE от Amazon — миллион коротких фраз вроде команд голосовому помощнику, переведённых на 52 языка. Из каждого языка она взяла одни и те же 2033 фразы и посчитала их длину в токенах токенизатором GPT-4 — cl100k_base. Медианная длина на английском — 7 токенов. На хинди — 32, в четыре с половиной раза больше. На бирманском — 72, в десять раз больше. Испанский, французский, португальский — примерно как английский; армянский и амхарский — в разы длиннее.
Значит, тот же смысл на бирманском модель генерирует примерно в десять раз дольше, а через API это примерно в десять раз дороже. Если пользователи вашего приложения пишут не на английском, посчитайте токены на их языке — например, токенайзером OpenAI.
Переход Что с этим делают?
Источники Йенни Джун — All languages are NOT created (tokenized) equal, 2023 ; набор MASSIVE ; OpenAI Tokenizer .
15 Свои модели
Ответ — модели, заточенные под язык
Самый активный язык после английского — китайский. Список на 2026 год, и он далеко не полный.
Текст Поэтому появилось много моделей, которые учили с упором на конкретный язык. Самый активный после английского — без сомнения, китайский. В книге упомянуты ChatGLM, YAYI и Llama-Chinese, но к 2026 году на первый план вышли другие: Qwen от Alibaba, DeepSeek, GLM от Zhipu — это наследник ChatGLM — и Kimi от Moonshot AI. Многие из них открытые и сильны далеко не только в китайском.
Есть и русские модели: GigaChat от Сбера, Алиса AI от Яндекса — бывшая YandexGPT — и T-Pro от Т-Банка. Французские — Lucie и CroissantLLM. Арабские — Jais 2, саудовская ALLaM и Falcon Arabic из Абу-Даби. Вьетнамские — PhoGPT от VinAI, Vistral и SeaLLM — модель для языков Юго-Восточной Азии.
Как показывать Значки на слайде — монограммы, не официальные логотипы. Номера версий не пишу намеренно: они меняются каждые пару месяцев.
Переход С языками разобрались. Второе измерение — предметные области.
16 Предметные области
Модель сильна в том, что было в данных
Темы сайтов в наборе C4 по исследованию Washington Post, 2023 , %
16
Бизнес и промышленность 11
Искусство и развлечения
Текст Модели общего назначения вроде Gemini, GPT и Llama хорошо отвечают про программирование, право, науку, бизнес, спорт. В основном потому, что эти области были в их обучающих данных.
Вот темы сайтов в C4 по анализу Washington Post: больше всего бизнеса и промышленности — 16%, технологий — 15%, новостей — 13%. Меньше всего — закона и правительства, 4%. Важная оговорка: анализ показывает только категории, которые в наборе есть, — чего в нём нет, на диаграмме не видно.
С картинками сложнее: их труднее классифицировать, и таких анализов почти нет. О доменах модели судят по тестам — например, CLIP и OpenCLIP проверяют на птицах, цветах, машинах, дорожных знаках. Точность там скачет от 15 до 80% в зависимости от набора. Но мир гораздо больше этих нескольких категорий.
Переход А есть задачи, где общая модель почти наверняка провалится.
Источники Рисунок 2.3 и таблица 2.3 книги; Washington Post, 2023 ; OpenCLIP .
18 Предметные модели
Своя область — своя модель
DeepMind
AlphaFold
Обучена на последовательностях и 3D-структурах около 100 000 известных белков.
alphafold ↗
NVIDIA
BioNeMo
Биомолекулярные данные для поиска лекарств.
bionemo ↗
Google
Med-PaLM 2
LLM плюс медицинские данные: точные ответы на медицинские вопросы.
med-palm ↗
Не только медицина: модель на архитектурных эскизах полезнее архитектору, чем Stable Diffusion, а модель на планах фабрик — производству, чем ChatGPT.
Текст Самая известная предметная модель — AlphaFold от DeepMind: её обучили на последовательностях и трёхмерных структурах примерно ста тысяч известных белков. BioNeMo от NVIDIA работает с биомолекулярными данными для поиска лекарств. Med-PaLM 2 от Google соединяет возможности LLM с медицинскими данными, чтобы точно отвечать на медицинские вопросы.
Больше всего таких моделей в биомедицине, но идея работает везде. Модель, обученная на архитектурных эскизах, может оказаться полезнее архитектору, чем Stable Diffusion, а модель на планах фабрик — полезнее производству, чем ChatGPT.
Переход Подведу итог.
19 Итог
Выводы
01 Модель — это её данные. Чего не было в обучении, того она не умеет.
02 Интернет-данные дешёвые, но грязные. Качество часто важнее объёма.
03 Английский доминирует. На других языках модели ошибаются чаще, отвечают медленнее и стоят дороже.
04 Узкой области — свои данные. Для медицины и науки нужны свои наборы и модели.
«Модель AI хороша настолько, насколько хороши данные, на которых она обучалась»
Чип Хьюен · AI-инженерия, глава 2
Текст Первое: модель — это её данные; чего не было в обучении, того она не умеет. Второе: интернет-данные дешёвые, но грязные, и качество часто важнее объёма. Третье: английский доминирует — на других языках модели ошибаются чаще, работают медленнее и стоят дороже. Четвёртое: узкой области нужны свои данные, а часто и свои модели.
Практический вывод для нас, разработчиков приложений: прежде чем выбирать модель, спросите себя, были ли ваш язык и ваша предметная область в её данных, — и проверьте это на своих примерах.
Переход А дальше Артём расскажет о второй половине уравнения — как устроена сама модель: архитектура и размер. Спасибо!
 Антон Помазков
 Артём Никифоров